
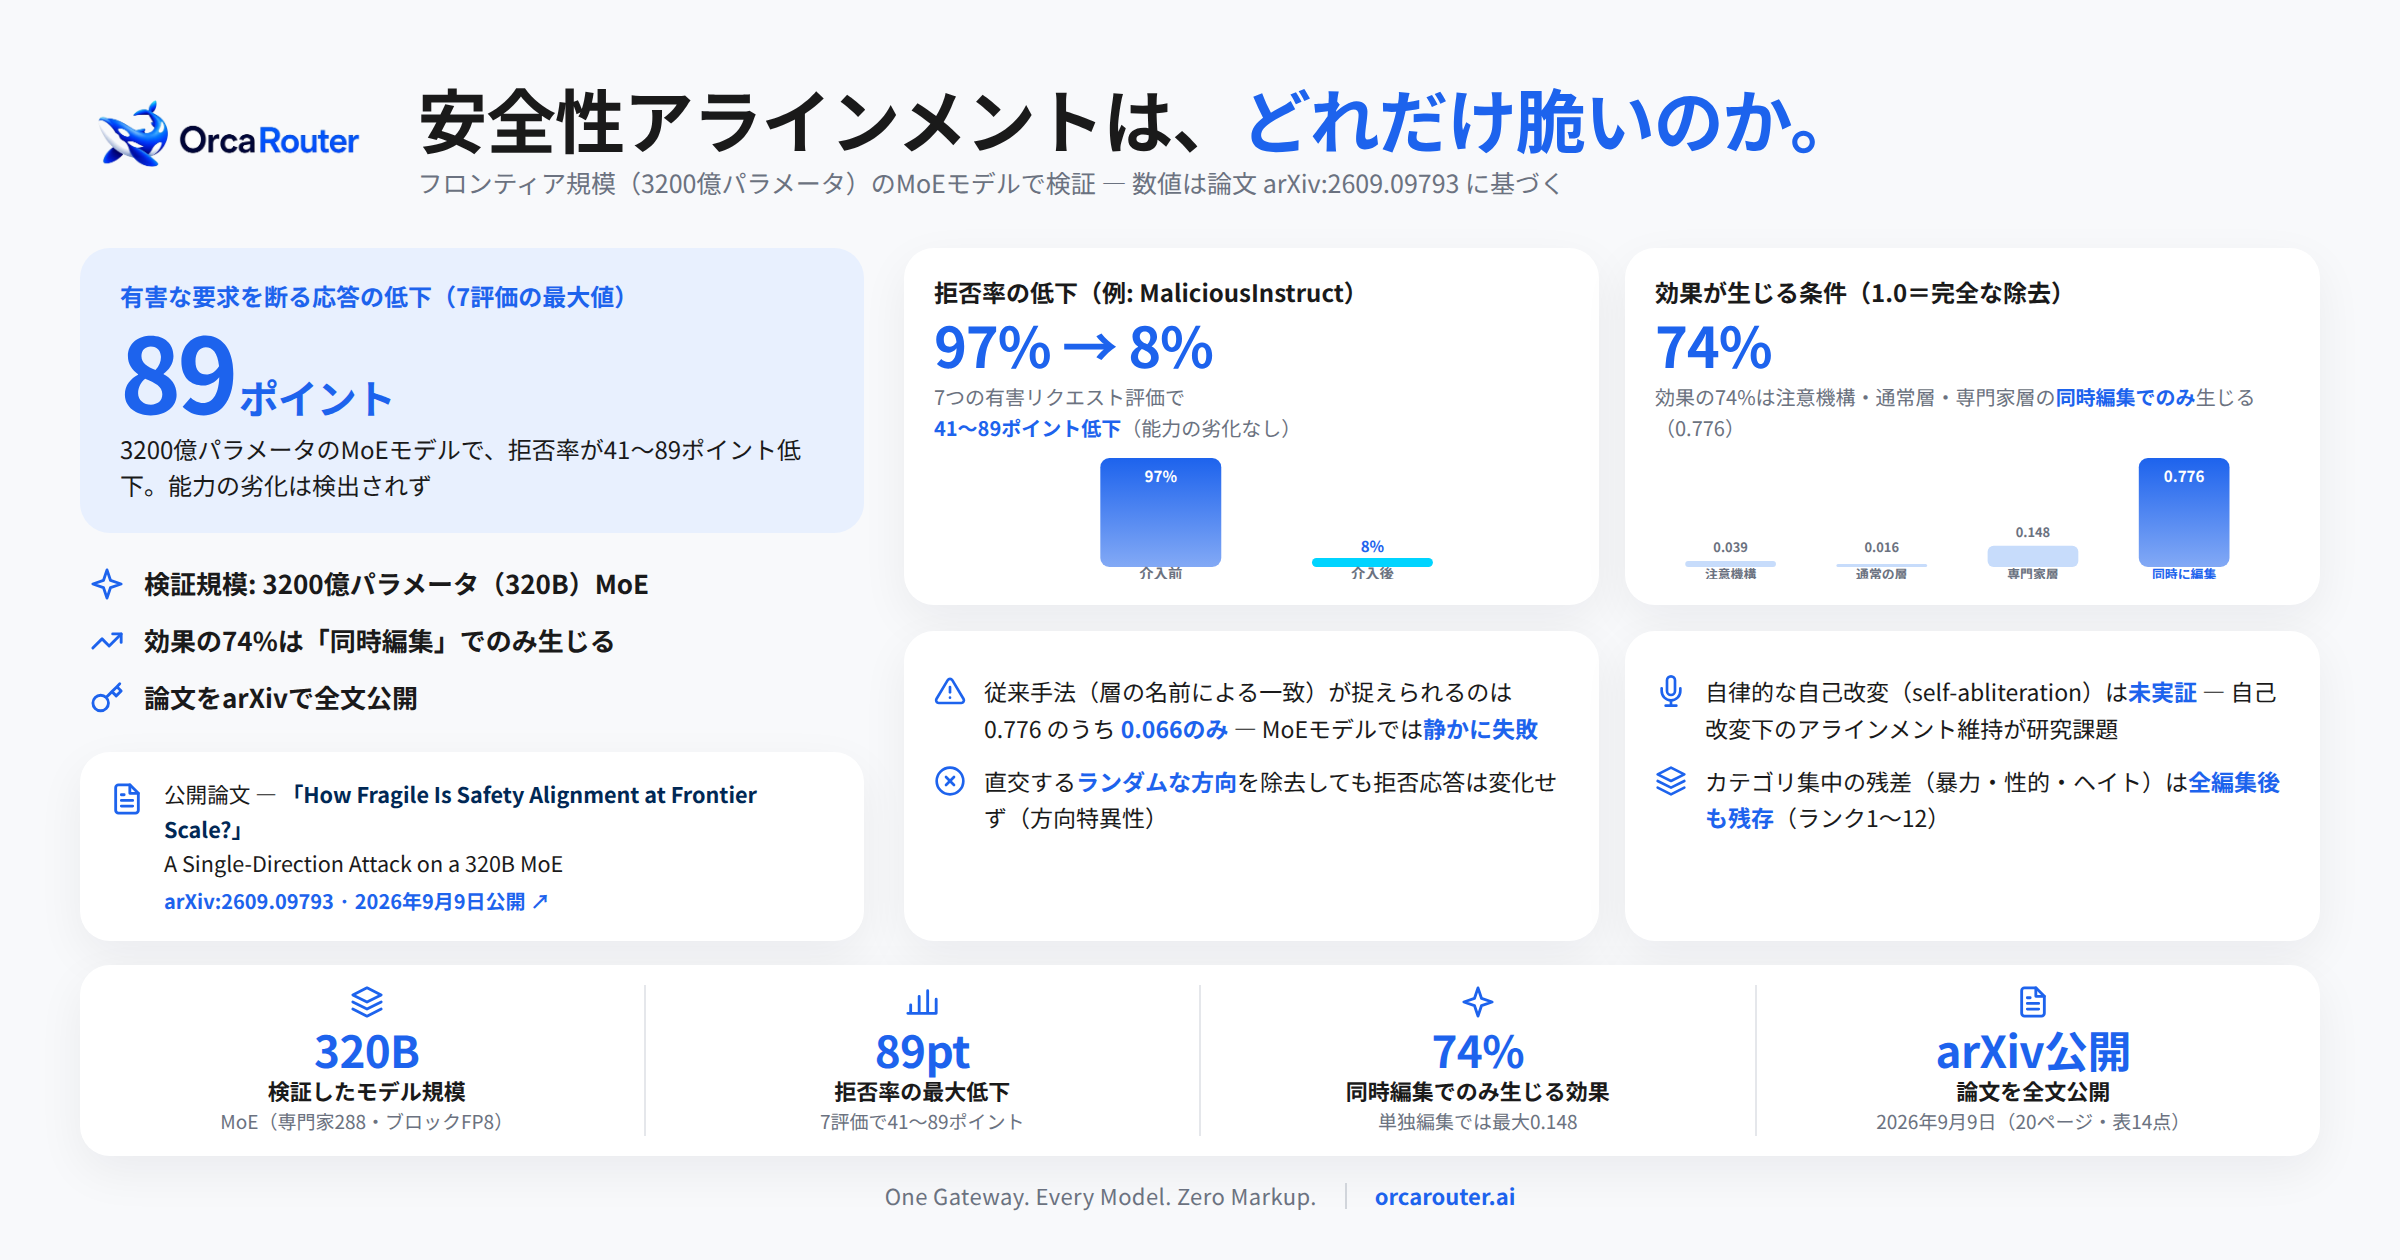
FlashLabs(東京都千代田区)が日本独占で提供するAI推論ゲートウェイ「OrcaRouter」を開発する米Continuum AI研究チームは、3200億パラメータ(320B)のMoEモデルで有害要求への拒否応答が重み編集で大幅に低下し得るとする論文を公開しました。7つの有害リクエスト評価で拒否率は41〜89ポイント下がり、例としてMaliciousInstructは97%から8%に低下しました。
対象は320BのMoE(Mixture of Experts、複数の専門家層を切り替える構造)モデル「GLM-5.3-Flash」です。モデル重みから「拒否応答を担う1つの方向」を除去する編集を行い、有害リクエストへの拒否率変化と性能劣化の有無、編集箇所(注意機構・通常層・専門家層)の単独/同時編集差、方向の特異性を評価しました。
拒否率の具体例ではAdvBenchが97%から13%、JailbreakBenchが94%から15%に下がりました。編集の到達度は注意機構・通常層・専門家層の同時編集で0.776(1.0が完全除去)に達した一方、単独編集は0.039・0.016・0.148にとどまり、効果の74%が同時編集でのみ生じるとされます。さらに、従来手法で捉えられる量は0.066に限られる結果も示されました。
背景には、オープンウェイトモデルの普及で能力を維持したまま安全性が失われ得る懸念があり、従来は約700億規模までの密なモデル中心だった検証をフロンティア規模MoEへ拡張する狙いがあります。今後はアーキテクチャ変化に追随した評価手法の整備が焦点となり、FlashLabsは透明性重視の姿勢を継続しつつ、OrcaRouterでのガードレールなど安全機能提供を続けるとしています。
【関連リンク】
OrcaRouter公式HP: https://www.orcarouter.ai/ja
FlashLabs公式HP: https://www.flashlabs.ai
Continuum AI公式HP: https://www.continuum01.ai